人们通常把翻译的起源想象为核糖体的突然组装。本页采取了一条不同的路径:它从 前生命时期氨基酸的丰度 出发,并追问最早的翻译装置必然属于怎样一种更高层次的组织。
从前生命化学到最早的字母表
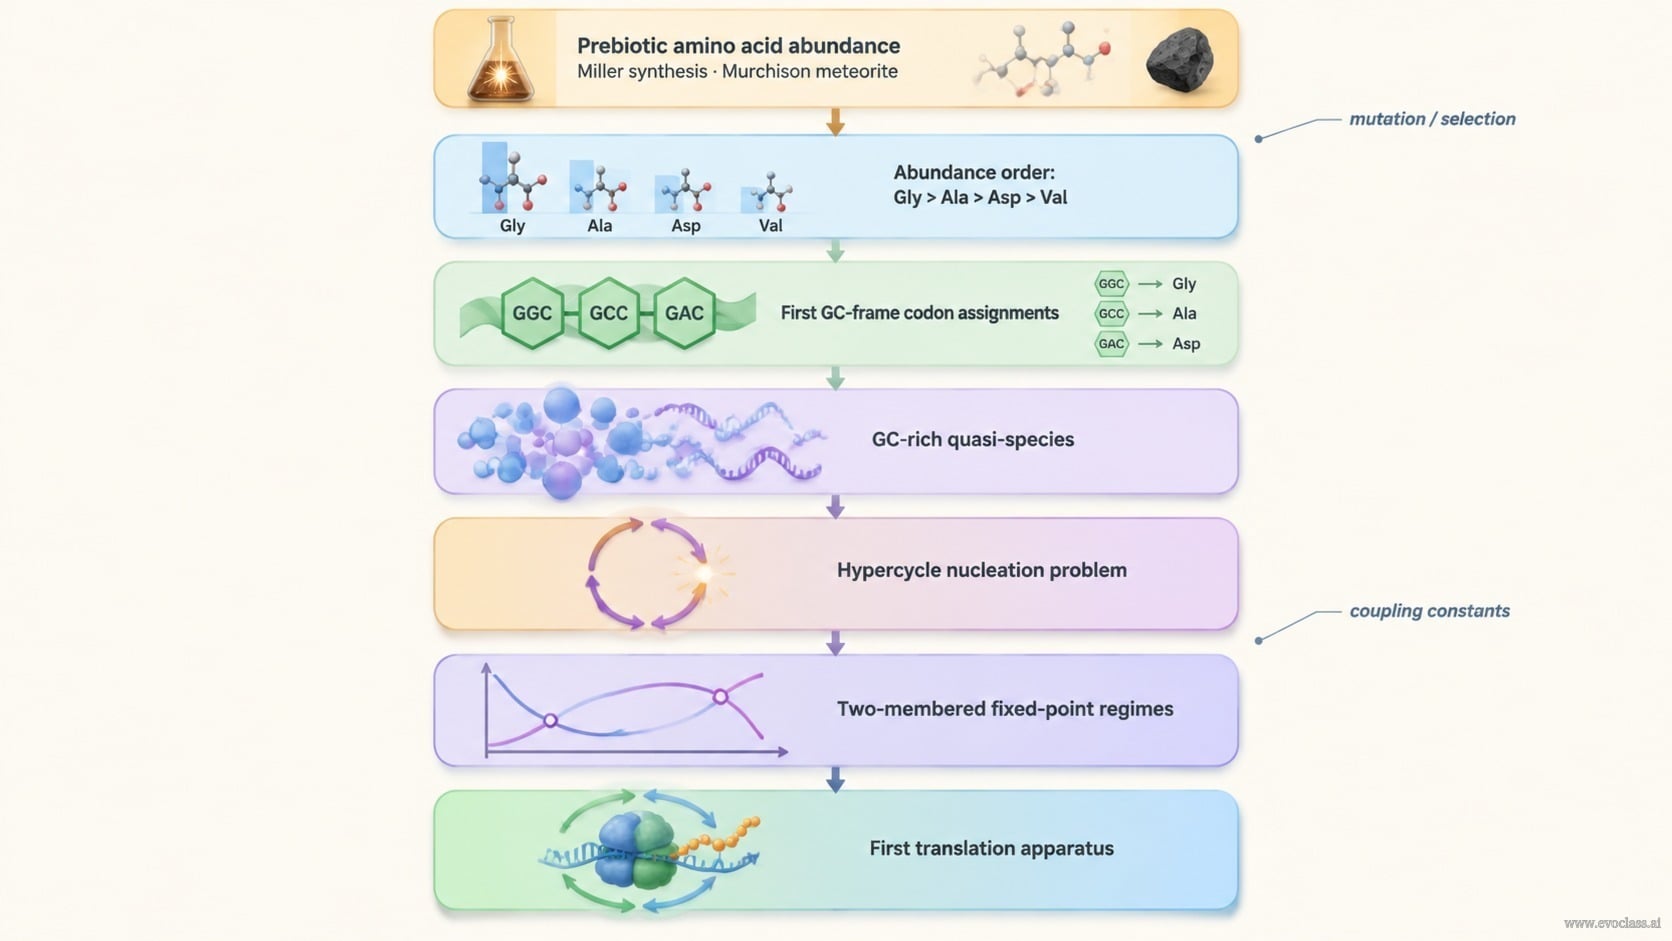
模拟的前生命合成(Miller 型实验)与 Murchison 陨石的有机分子清单,共同指向一个有限的 脂肪族氨基酸家族。产量与陨石丰度并非均匀分布,而是明显偏向:甘氨酸占主导,其次是丙氨酸、天冬氨酸和缬氨酸。这种偏向正是最早遗传字母表得以取材的原料。
丰度次序与最早的 GC 框密码子
次序 Gly > Ala > Asp > Val 被用来排列最早的 GC 框密码子分配。由 G 和 C 组成的密码子最先对应最简单、最丰富的氨基酸,从而使化学丰度与早期编码模式相互契合。按此解读,最早的编码系统是一个富含 GC 的系统,其密码子分配是可获得性的结果,而非偶然。
超循环的成核问题
超循环的行为与单个自催化复制子不同。单个复制子原则上可以从单一份模板开始;而环状网络则不行,因为闭合环路需要其所有成员同时存在。因此,最早的翻译装置并非一项孤立的分子发明,它必须由富含 GC 的准物种逐步组装而成,通过突变和选择一步步添加并完善其组分,直到循环闭合。
二元超循环的不动点
对二元超循环的不动点分析表明,其结果取决于 相对耦合常数 即连接各成员的耦合强度。会出现三种定性区间:直接竞争,即一方胜过另一方;任一方被选择,取决于初始条件;以及相互的超循环稳定化,即双方彼此增强。只有最后一种区间支持与翻译耦合的装置,因为在这种情况下,RNA 复制与肽合成相互强化,而非相互竞争。
翻译是一个阈值,而非一项发明
由此浮现的图景是:最早的翻译装置是一个 超循环系统中的阈值 它将 RNA 复制、肽合成与催化闭合联系在一起。贯穿始终的问题是 XI. 翻译如何起始? 上方的路线图给出了答案:起点是化学丰度,终点则是通过突变、选择和充分耦合而达到的一个自我强化循环。
前生命氨基酸与最早的翻译装置一张分阶段的路线图将原始氨基酸丰度(Miller 型合成与 Murchison 陨石数据)与最早的翻译装置联系起来。它依次经过丰度次序 Gly > Ala > Asp > Val、最早的 GC 框密码子分配、富含 GC 的准物种、超循环的成核问题,以及二元循环的不动点区间,最终抵达由 RNA 复制、肽合成和催化闭合共同维系的翻译装置。